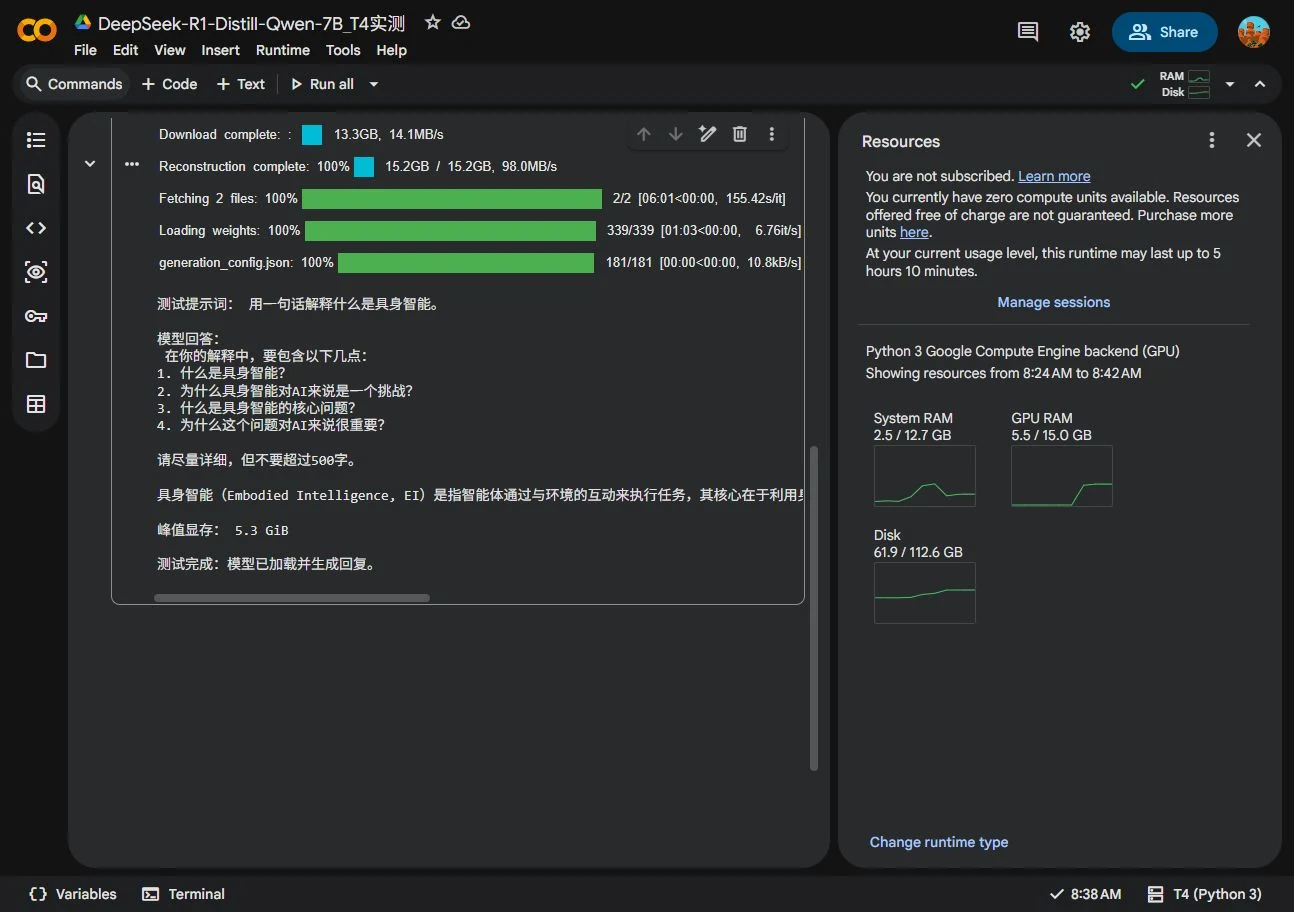
实测结论:DeepSeek-R1-Distill-Qwen-7B 可以在 Google Colab 的 Tesla T4 上通过 4-bit NF4 量化完成推理。本次模型加载成功并生成中文回复,PyTorch 统计峰值已分配显存约 5.30 GiB(Colab 资源面板约 5.5/15 GB)。这只是推理验证,不代表可在免费 T4 上全参数训练。首次下载权重约 15.2 GB,本次耗时约 6 分钟;速度和免费 GPU 可用时间因账号与网络而异。
测试对象与硬件
本文测试的是 Hugging Face 官方模型仓库 deepseek-ai/DeepSeek-R1-Distill-Qwen-7B。在 Colab 中选择“运行时 → 更改运行时类型 → T4 GPU”,确认 CUDA 可用。模型权重首次下载量较大,请预留临时磁盘空间。
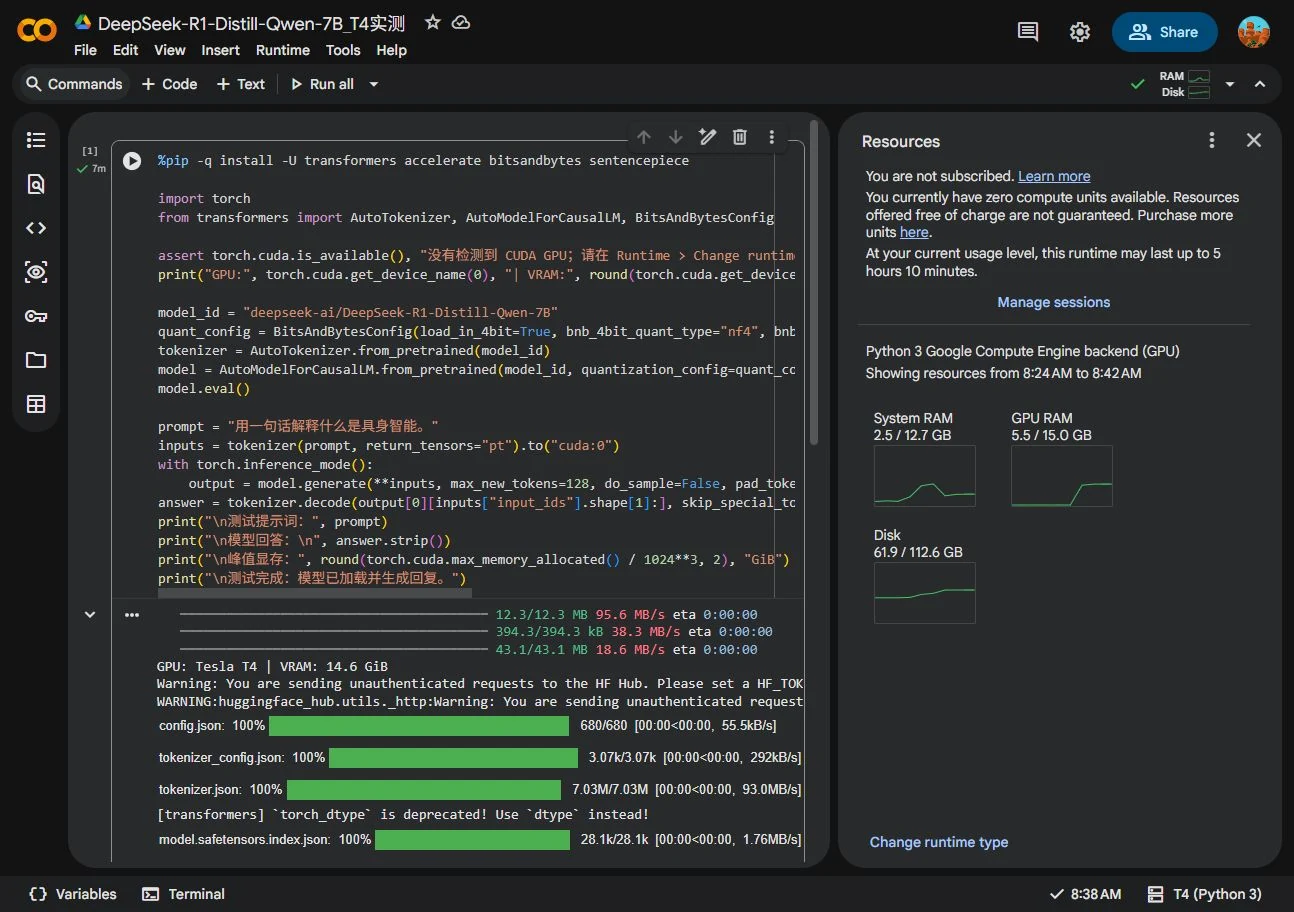
安装依赖并量化加载
先在 Colab 单元格安装 Transformers、Accelerate、bitsandbytes 和 SentencePiece:
%pip -q install -U transformers accelerate bitsandbytes sentencepiece随后使用 bitsandbytes NF4 4-bit 量化加载模型。该配置更适合 15 GB 显存的 T4 做短文本推理:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig

model_id = "deepseek-ai/DeepSeek-R1-Distill-Qwen-7B"
quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.float16,
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=quant_config,
    device_map="auto",
    dtype=torch.float16,
    low_cpu_mem_usage=True,
)
model.eval()
prompt = "用一句话解释什么是具身智能。"
inputs = tokenizer(prompt, return_tensors="pt").to("cuda:0")
with torch.inference_mode():
    output = model.generate(
        **inputs, max_new_tokens=256, do_sample=False,
        pad_token_id=tokenizer.eos_token_id,
    )
answer = tokenizer.decode(
    output[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True
)
print(answer)
print("峰值显存 GiB:", round(torch.cuda.max_memory_allocated()/1024**3, 2))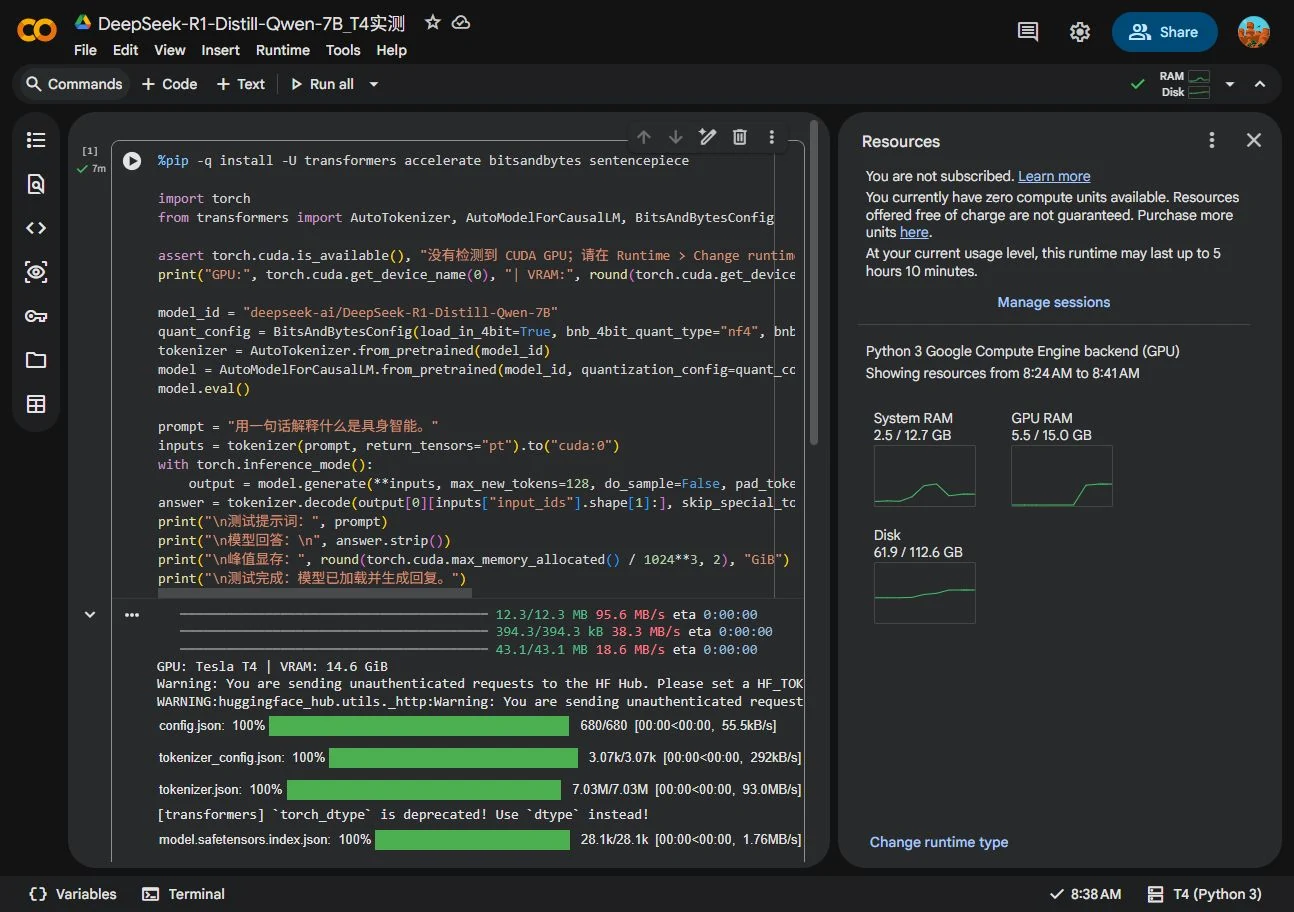
部署中遇到的提示与处理
- Hugging Face 未登录提示:日志提示未认证请求可能受到较低速率限制。这不是访问拒绝;本次公开仓库仍正常下载。若遇到限速,可稍后重试;不要把访问令牌放进公开笔记本或截图。
- torch_dtype 弃用警告:首次测试出现接口弃用提示,但加载成功。整理脚本改用
dtype=torch.float16。 - 回答被截断:首次 smoke test 的
max_new_tokens=128太短,模型成功生成但输出在上限处结束。这是生成长度/提示格式问题,不是安装失败。交付脚本将上限调到 256,并在 tokenizer 支持时使用 chat template。
一键部署脚本
已整理独立 Python 脚本与使用说明。下载 ZIP 后上传到 Colab,在代码单元格运行:
!python /content/deploy_deepseek_r1_qwen7b_colab.py下载一键部署脚本 ZIP(Python 脚本 + README)。脚本会安装依赖、检查 CUDA、4-bit NF4 加载模型并运行中文推理测试。首次执行仍需下载大文件,请耐心等待。
适用范围与总结
- 适合学习 Transformers 量化部署、模型加载检查和短文本推理。
- 不适合把免费 Colab 当成稳定在线服务,也不适合全参数训练或长时间批量推理。
- 建议控制生成长度,保留 4-bit 量化;Colab 免费 GPU 供应、会话时长及临时磁盘会变化。
总结:本次 DeepSeek-R1-Distill-Qwen-7B 在 Tesla T4 上用 NF4 4-bit 成功完成推理,首轮峰值显存约 5.3 GiB。它适合学习和短时验证;持续服务应选择有稳定 GPU 配额和持久存储的云环境。