MiniMax Music 3 是一款文本与歌词驱动的音乐生成模型。它到底能不能在 Google Colab 免费 Tesla T4 上真正生成音乐?这次我直接在 Colab T4 上安装官方 Diffusers 实现、下载模型权重、尝试低显存加载,并运行 10 秒音乐生成测试。结论先说:依赖安装、权重下载和模型加载都完成了,但 10 秒生成任务执行超过 1 小时 39 分钟仍未返回音频,因此本次不能算生成成功。下面把可复现的过程和限制完整记录下来。
测试环境与结论
- 运行环境:Google Colab 免费 GPU,Tesla T4
- 显存:15 GB 标称,PyTorch 报告约 14.56 GiB
- 系统内存:约 12.67 GiB;磁盘:约 112.64 GB
- 软件:torch 2.11.0+cu128、diffusers 0.40.0.dev0(实验性 Modular Diffusers)
- 结果:权重下载完成,管线组件加载并输出 LOAD_OK;10 秒生成单元格等待超过 1 小时 39 分钟,Colab 随后断开运行时,没有产出或验证 WAV。
这说明 T4 可以承担下载与低显存加载实验,但在本次免费的 Colab 会话中,不能据此承诺可实用地生成音乐。免费额度不保证持续时长,长时间等待也可能被运行时回收。
安装依赖与检查 T4
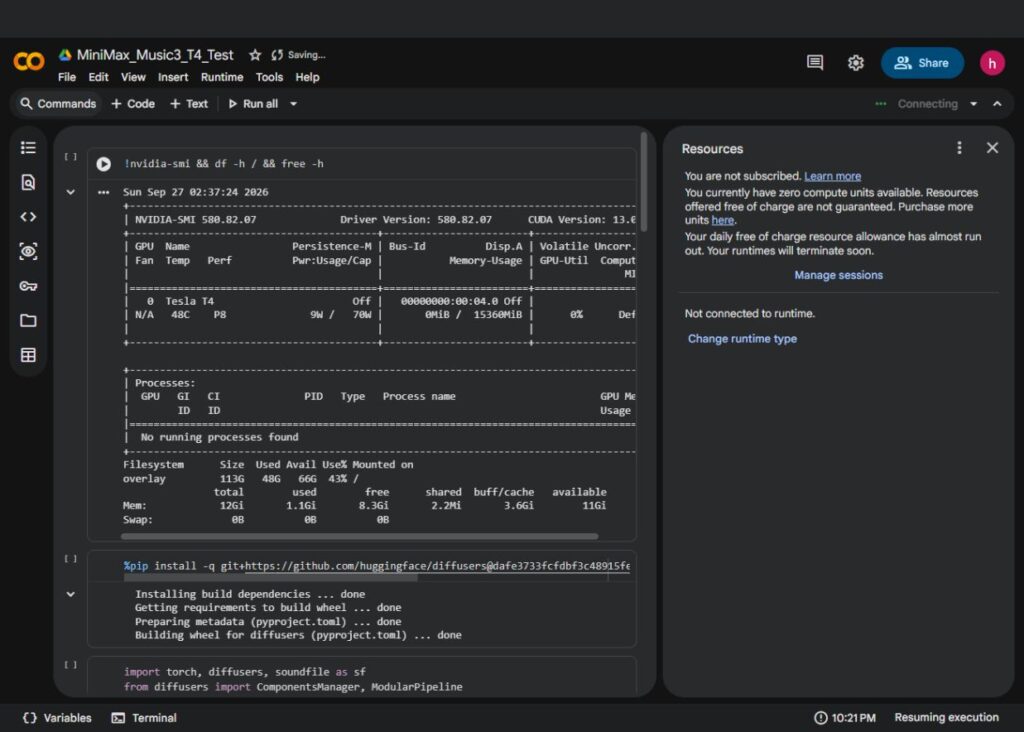
本次使用 Hugging Face Diffusers 仓库中的固定提交安装开发版,再检查设备和 BF16 支持。Colab 中执行:
%pip install -q git+https://github.com/huggingface/diffusers@dafe3733fcfdbf3c48915fe77be3aef65b5d6a2d transformers accelerate soundfile

import torch, diffusers
print(torch.__version__, diffusers.__version__)
print(torch.cuda.get_device_name(0))
print(torch.cuda.is_bf16_supported())
print(torch.cuda.get_device_properties(0).total_memory / 2**30, "GiB")
测试环境返回 Tesla T4,BF16 支持为 True。安装过程中出现 Modular Diffusers 仍处于实验开发阶段的提示;这是版本风险提示,不等于安装失败。
下载模型与加载过程
通过 ModularPipeline.from_pretrained("MiniMaxAI/MiniMax-Music3") 获取模型。日志显示一个主要音频/流组件约 9.73 GB,语言模型约 17.2 GB,权重分片加载到 399/399。Hugging Face 未登录提示只说明
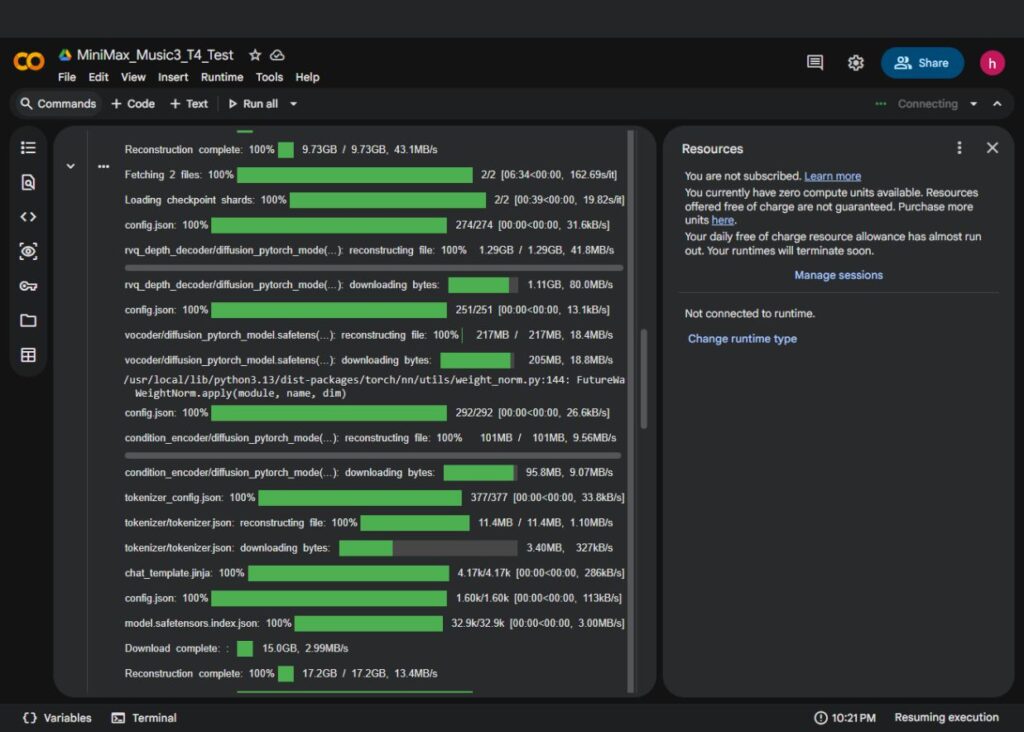
匿名请求可能有速率限制;这次文件最终下载完成。
第一次常规加载未能稳定进入可用状态。之后重新连接 Colab 并尝试 CPU 自动卸载、BF16 加载和语言模型分组卸载到磁盘;日志确实到达 LOAD_OK。需要注意,日志还显示传入的 low_cpu_mem_usage 参数被忽
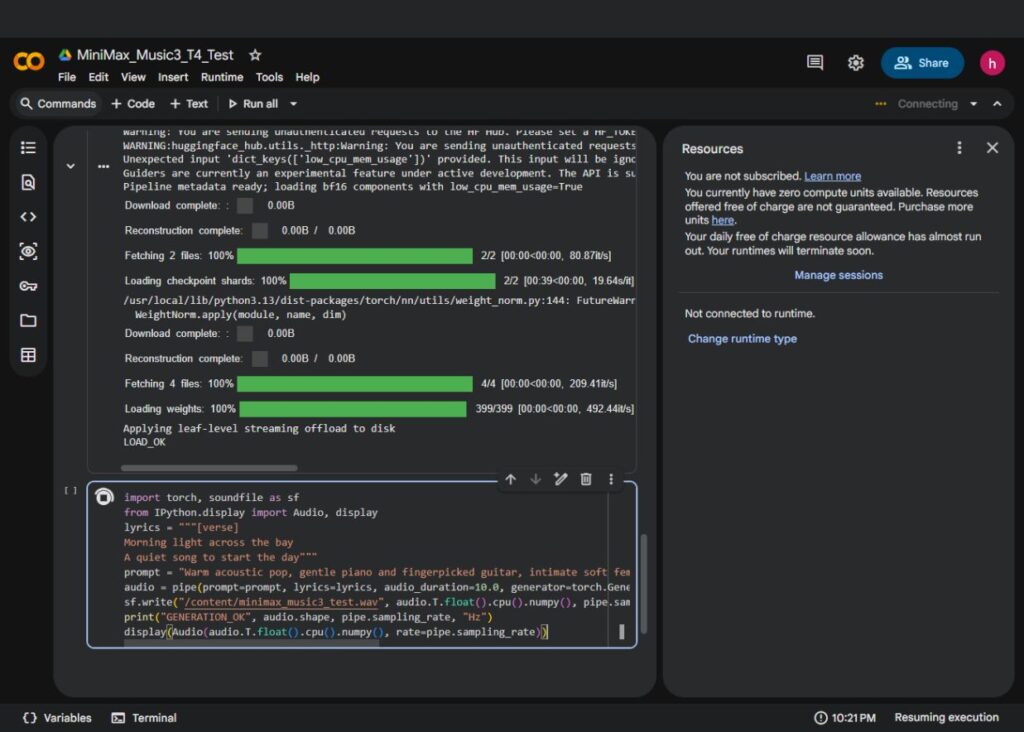
略,因此不能把它说成有效的省内存参数。真正可确认的是:当前这组操作加载完成了,但还没有证明生成阶段可行。
本次加载代码
下面是本次采用的核心加载方式。Colab 免费实例重连或重置后,内存中的管线会消失,需要重新运行;已下载缓存是否保留取决于运行时是否还在。
import os, torch
from diffusers import ComponentsManager, ModularPipeline
from diffusers.hooks import apply_group_offloading

os.makedirs("/content/minimax_offload", exist_ok=True)
manager = ComponentsManager()
manager.enable_auto_cpu_offload(device="cuda")
pipe = ModularPipeline.from_pretrained(
    "MiniMaxAI/MiniMax-Music3", components_manager=manager, low_cpu_mem_usage=True
)
pipe.load_components(dtype=torch.bfloat16, low_cpu_mem_usage=True)
apply_group_offloading(
    pipe.language_model,
    onload_device=torch.device("cuda"),
    offload_type="leaf_level",
    use_stream=True,
    low_cpu_mem_usage=True,
    offload_to_disk_path="/content/minimax_offload",
)
print("LOAD_OK")
10 秒音乐生成实测:等待很久仍无结果
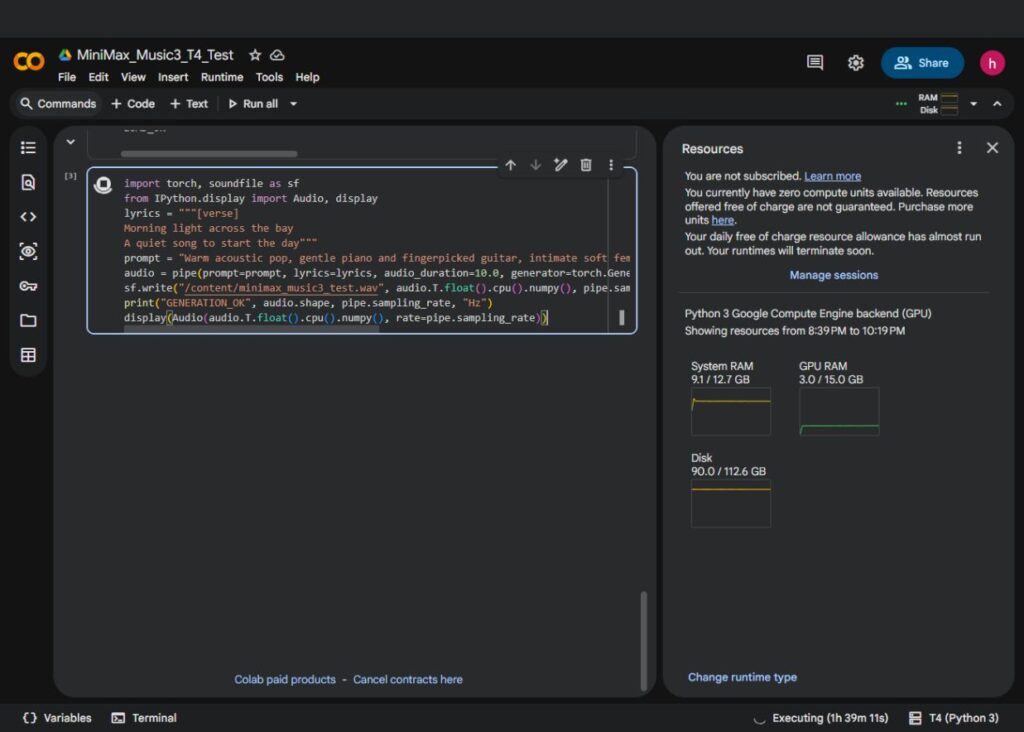
模型加载后,使用短歌词和 10 秒时长做最小生成测试,代码如下。单元格启动后超过 1 小时 39 分钟仍显示 Executing,没有输出 GENERATION_OK,也没有可播放音频。因此这次的真实结果是“生成未验证/未在可接受时间内完成”,不是成功生成,也不能仅凭一次卡住就断言模型绝对无法生成。
import torch, soundfile as sf
from IPython.display import Audio, display

lyrics = """[Verse]
Morning light across the bay
A quiet song to start the day"""
prompt = "Warm acoustic pop, gentle piano and fingerpicked guitar, intimate soft female vocal, clear melody, calm hopeful mood, polished studio production."
audio = pipe(
    prompt=prompt,
    lyrics=lyrics,
    audio_duration=10.0,
    generator=torch.Generator("cuda").manual_seed(7),
    output="audios",
)[0]
sf.write("/content/minimax_music3_test.wav", audio.T.float().cpu().numpy(), pipe.sampling_rate)
print("GENERATION_OK", audio.shape, pipe.sampling_rate, "Hz")
display(Audio(audio.T.float().cpu().numpy(), rate=pipe.sampling_rate))
遇到的现象与处理
- Hugging Face 匿名访问提示:属于速率提醒;本次下载仍完成。大规模或频繁下载时可按官方方式配置访问令牌,但不要把令牌写进公开 Notebook 或文章。
- 实验性 API 提示:Modular Diffusers API 仍在迭代,固定仓库提交有助于复现,但不保证未来版本兼容。
- 内存压力:T4 的显存约 14.56 GiB、主机内存约 12.67 GiB。通过 CPU/磁盘卸载后模型才输出 LOAD_OK;这是以速度和磁盘 I/O 换内存。
- 生成长时间无返回:观察到执行持续、GPU 显存约 3 GB、RAM 约 9.1 GB、磁盘约 90/112.6 GB;没有拿到最终 traceback,也没有 WAV,故不能编造具体根因。不要把“继续等”当作可用部署方案。
最实用的建议
如果目标是快速试听 MiniMax Music 3,优先使用项目提供的托管演示或有足够显存、内存和本地 SSD 的 GPU 环境;先对照官方模型卡和推理示例确认当前依赖版本。若坚持 Colab T4,建议把它定位为下载、代码兼容性和小规模加载测试环境,不要承诺免费 T4 能稳定完成歌曲生成。更可靠的下一步是换持续时间可控、内存更大的付费 GPU 实例,设置任务超时并监控 GPU/CPU/磁盘 I/O,然后重新做同一条 10 秒基准测试。
资源链接
- 模型卡:MiniMaxAI/MiniMax-Music3
- 本次 Colab Notebook:MiniMax Music 3 T4 实测(需有权限访问)
复现提醒:Colab 免费 GPU、磁盘和会话时长均可能变化;本文记录的是本次会话实测,不构成所有运行
环境的性能保证。由于生成单元格尚未返回,本篇不附伪造的成功音频或成功截图。