Qwen-Image-2.1是面向图像生成与编辑的模型。它能不能在 Google Colab 免费 T4 上跑?我们这次不只看参数表,而是在免费 Colab 实际下载官方权重、尝试常规 FP16 加载、记录内存崩溃,再用官方 Diffusers 的 bitsandbytes NF4 量化重新部署并生成图片。
先给结论:原始仓库约 33.1 GB,T4 的 15 GB 显存不是唯一瓶颈;免费 Colab 这次分配到的主机内存约 12.7 GB,常规 FP16 加载和磁盘 offload 两次都在载入权重时触发 RAM OOM。改为对 Transformer 与文本编码器做 NF4 4-bit 量化后,完整官方 2.1 Pipeline 成功载入,占用约 10.66 GiB GPU 内存,并在 22 秒内生成 512×512 图片。结论是:原版不量化不适合这档免费 T4 环境;量化后可以实测运行,不必先换成旧版本。
本文代码与截图来自真实 Colab 操作。免费运行时资源由 Google 动态分配,硬件和持续时间可能变化,本文数据是本次实测而非保证值。
一、Colab 免费 T4 实测配置
本次运行时报告 Tesla T4,显存 14.56 GiB(Colab 面板约 15 GB),系统 RAM 12.67 GB,磁盘 112.64 GB。Python 3.13.15、PyTorch 2.11.0+cu128。Hugging Face 仓库文件总量约 33.1 GB:磁盘足够下载,但把组件反序列化到主机内存时,12.7 GB RAM 成了实际瓶颈。
模型卡推荐的常规示例使用 BF16 与较大分辨率;T4 不是适合原样照搬该示例的设备。这里用 FP16,并且把“能下载”与“能载入并推理”分开验证。
二、安装依赖:先升级,再重启运行时
在 Colab 新建 Notebook,菜单选择“代码执行程序 → 更改运行时类型 → T4 GPU”。先运行下面安装单元。此次 Colab 预装的 torchao 0.10.0 缺少 Diffusers 所需接口,因此一并升级;包更新后按提示重启运行时,再继续后续代码。
%pip install -U "transformers>=5.17.0" accelerate pillow safetensors bitsandbytes
%pip install -U git+https://github.com/huggingface/diffusers
%pip install -U --no-deps "torchao>=0.15.0"
# 安装完成后:Runtime(运行时)→ Restart session(重启会话)
重启后验证 GPU,并确认运行时仍分配到 T4:
import torch, sys
print("Python:", sys.version)
print("PyTorch:", torch.__version__)
print("GPU:", torch.cuda.get_device_name(0))
print("VRAM GiB:", round(torch.cuda.get_device_properties(0).total_memory / 1024**3, 2))
三、先试原始精度:权重能下,加载会 OOM
我们先按 FP16 + CPU offload 尝试,完整 33.1 GB 权重下载成功;加载到约 27% 时,系统 RAM 已升至 12.1/12.7 GB。
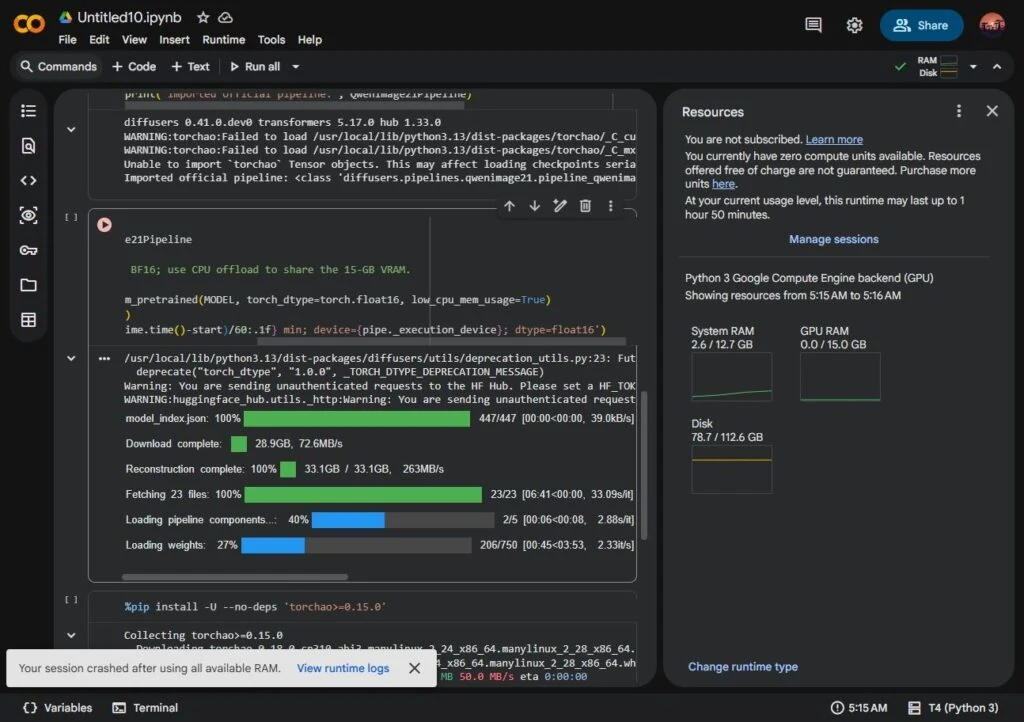
Colab 随后提示会话因使用完所有 RAM 而崩溃。继续尝试 balanced device map、限制 CPU/GPU 内存并设置磁盘 offload 后,仍在权重加载阶段耗尽主机内存。注意:这次观察到的是系统 RAM OOM,不应误称为 CUDA 显存不足。图 2:Colab 的真实崩溃提示,以及权重载入时的资源面板。
因此“多加一个 enable_model_cpu_offload()”并没有解决此配置下的加载峰值内存问题。若你的 Colab 分到更大主机 RAM,结果可能不同;本文结论针对本次免费 T4 实例。
四、可行方案:官方 Diffusers + NF4 4-bit 量化
不必切换到 Qwen-Image 旧版本:保留 Qwen-Image-2.1 原模型,通过 Diffusers 与 bitsandbytes 在载入时对 Transformer、文本编码器做 NF4 4-bit 量化。VAE 保持 FP16。此方案成功载入所有 5 个 Pipeline 组件、750/750 权重张量,GPU 分配约 10.66 GiB。
import torch, time
from diffusers import QwenImage21Pipeline
from diffusers.quantizers import PipelineQuantizationConfig

model_id = "Qwen/Qwen-Image-2.1"
quant_config = PipelineQuantizationConfig(
    quant_backend="bitsandbytes_4bit",
    quant_kwargs={
        "load_in_4bit": True,
        "bnb_4bit_quant_type": "nf4",
        "bnb_4bit_compute_dtype": torch.float16,
    },
    components_to_quantize=["transformer", "text_encoder"],
)

start = time.time()
pipe = QwenImage21Pipeline.from_pretrained(
    model_id,
    dtype=torch.float16,
    low_cpu_mem_usage=True,
    device_map="cuda",
    quantization_config=quant_config,
)
print(f"载入耗时:{(time.time()-start)/60:.1f} 分钟")
print("GPU 已分配 GiB:", round(torch.cuda.memory_allocated()/1024**3, 2))
如果导入时报 torchao 缺少 FqnToConfig,检查 torchao 是否已升级并重启会话。不要在安装完成前先 import Diffusers,否则旧模块可能仍留在当前 Python 进程里。
五、真实生成测试:512×512,20 步
加载成功还不够,我们用 20 步生成实际图片。Qwen-Image-2.1 的 Pipeline 参数与旧版不同:本次实测采用默认 true_cfg_scale,不传旧版 guidance_scale。测试 prompt 是英文的简洁插画描述,固定随机种子便于复现。
from IPython.display import display
import time

prompt = "A clean editorial illustration of a tiny friendly robot painting a sunset in a studio, warm orange light, simple composition, no text."
start = time.time()
with torch.inference_mode():
    image = pipe(
        prompt,
        width=512,
        height=512,
        num_inference_steps=20,
        generator=torch.Generator("cuda").manual_seed(42),
    ).images[0]
image.save("/content/qwen21_t4_nf4_20steps.png")
print("尺寸:", image.size, "耗时:", round(time.time()-start, 1), "秒")
display(image)
图 3:本次 20 步推理输出(Colab 页面真实截图,非 AI 后期合成配图)。
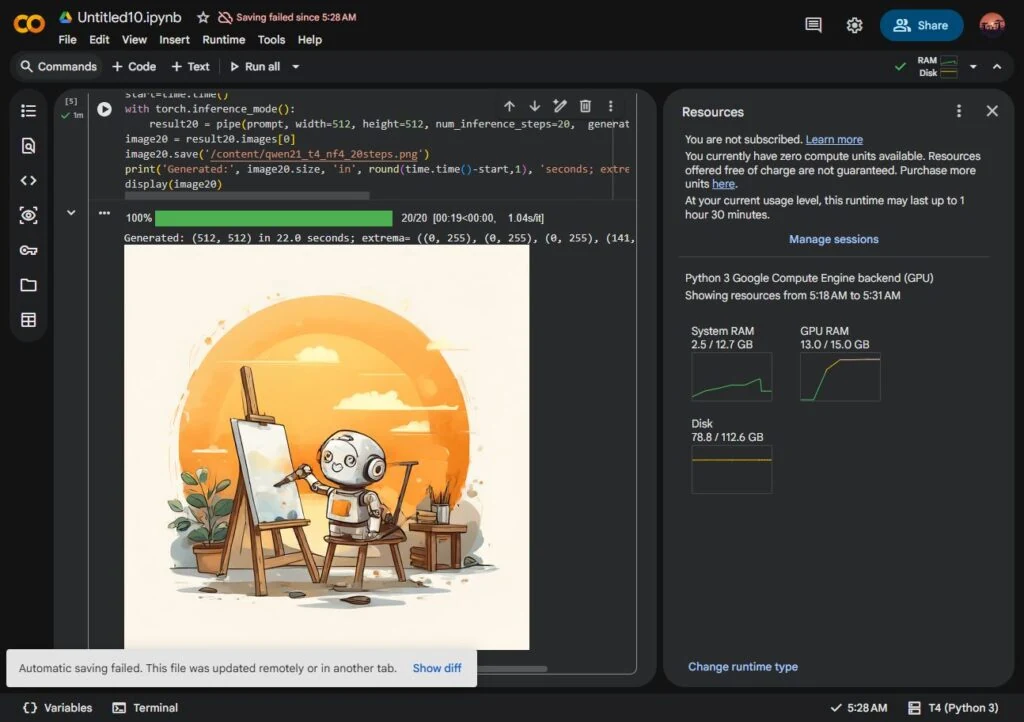
结果为 512×512,推理耗时约 22 秒,输出像素有完整动态范围,画面主体清晰。4 步快速冒烟测试虽然成功返回图片,但画面过淡,所以不把它当作有效效果展示;最终结论基于 20 步结果。
六、常见问题与排错
- 下载了 33 GB 为什么还装不上?磁盘空间与加载时主机 RAM 是两回事;本次 OOM 发生在组件载入阶段。
- 报错称没有 FqnToConfig?升级 torchao 至 0.15 或更新版本,重启 runtime 后再 import。
- 提示不支持 guidance_scale?那是旧版 Pipeline 参数;Qwen-Image-2.1 请按当前 API 使用 true_cfg_scale,或像本次一样使用默认设置。
- 生成图很淡或接近空白?低步数只能做快速通路检查;请增加到 20 步左右后再判断画质。
- 每个人都能分到 T4 吗?不能保证。Colab 免费资源会变化,GPU、RAM、运行时长和可用性受当时配额影响。
七、最终结论与适用场景
本次验证的答案不是简单的“能”或“不能”:在免费 Colab T4 上,官方 Qwen-Image-2.1 原精度 Pipeline 因系统 RAM 不足而无法完成加载;采用 Diffusers 官方支持的 NF4 4-bit 量化后,同一模型成功运行并生成图片。适合体验模型、验证 prompt 和小尺寸出图;若要更高分辨率、连续批量生成或稳定生产,建议使用 RAM/显存更充足的 GPU 实例,并评估量化带来的画质差异。
一键复现顺序:选择 T4 → 运行依赖安装 → 重启会话 → 执行 NF4 Pipeline 载入代码 → 执行 20 步生成代码。完整 Notebook 实测副本:打开 Colab 实测笔记本(需登录创建副本后运行)。
一键运行脚本:下载 Qwen-Image-2.1 Colab T4 部署脚本(ZIP)并解压,将 .py 上传到 Colab 左侧“文件”面板,然后在代码单元运行 !python /content/qwen_image_21_colab_t4.py。脚本会自动安装依赖、下载约 33.1 GB 模型并生成测试图;首次运行需要较长下载时间,运行前先选择 T4 GPU。